


株式会社renue
renueについて
renueは、AIで業務を実装する会社です
AIコンサルティングから図面AI・広告運用エージェント・コールセンターAIまで、実際に動いているサービスをご覧いただけます。renueが何をしている会社か、まずはサービス一覧からご確認ください。
2023年始ごろより、ChatGPTの登場もあり大きく生成AI、特に自然言語モデルが話題になっているかと思います。多くの企業が「うちではAIを使ったサービスを出す予定です」と広報をしていますが、中にはリリースする前に品質が担保できずに困っている方も多いのではないでしょうか。本稿では、筆者が実際にAI研究・開発および通常の業務システム導入に関わってきた経験を元に、生成AIサービスを実際にリリースする上で課題になる品質担保について解説したいと思います。
システム開発の流れと品質担保
話が少し逸れますが、通常システムの開発ではAIほど混乱はなく、予定通りリリースされる事が多いかと思います。これは長年の経験を世界中で蓄積したプロジェクト管理技術によるモノです。その中でもまずは最も基本的とされる「ウォーターフォール」を前提として品質担保について説明します。
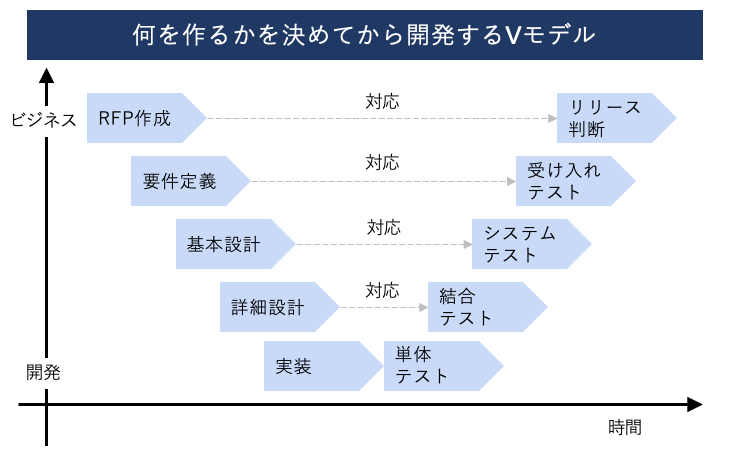
上記の図は「Vモデル」と呼ばれるシステム開発における大きな流れを説明する図です。縦軸がビジネス - 開発のグラデーションで、横軸はプロジェクト進捗の時間軸を表します。まず、プロジェクトで「何を達成するか」をRFP(提案依頼書)などの形で表し、そこから徐々に具体的な設計に移っていく流れです。一番下の「実装」まで到達した後は、テスト工程に移行し、それぞれ高さが一致する層の要件・設計を満たしているかを確認していくことになります。この手法により、厳密にシステム仕様を決めていく事で、手戻りが起こる可能性の低減と想定外の早期検知を可能にしています。
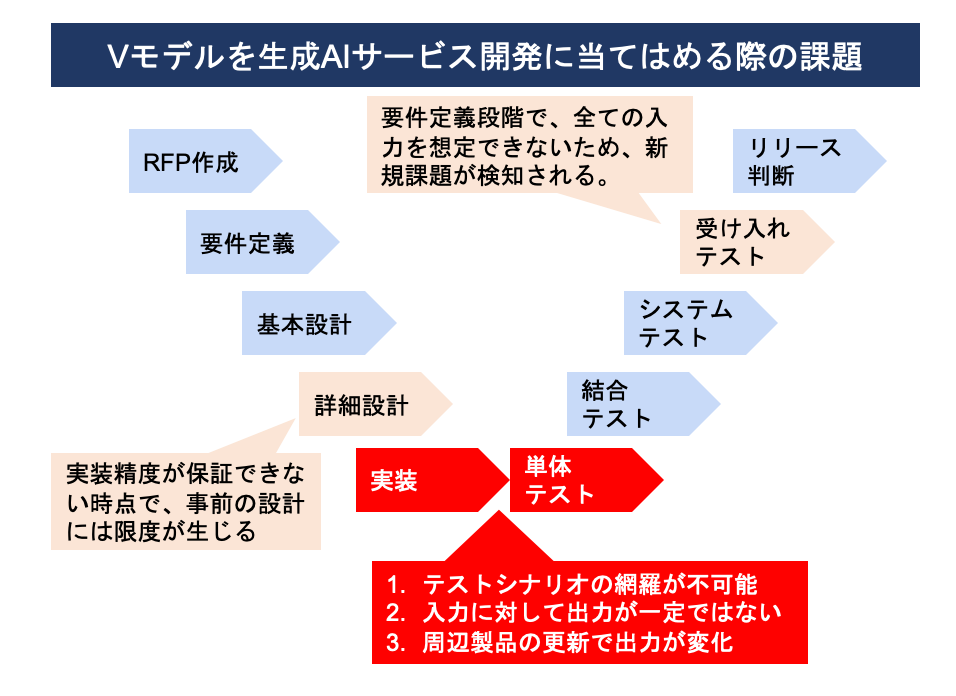
次にこのVモデルを前提とした時に、生成AIを組み込むと一番下に位置している実装・単体テストの領域で問題が起こる事を説明します。生成AIでは、サンプリングを使う生成方法や実行環境によって、同じ入力でも出力が変わる場合があります。一方、モデル・入力・生成設定・実行環境をそろえ、決定的な計算を用いて再現性を高めることもできます。全てのAIが毎回異なる答えを返すという意味ではありません(Transformersの生成設定、PyTorchの再現性の説明)。例えば、決定的な足し算処理の単体テストでは
足し算関数に、「1」と「1」を入力したら必ず「2」を返してくる
という期待値を確認できますが、この一例だけで関数全体の正しさを保証できるわけではありません。生成AIで自由文を出力する場合は、正しい表現が複数あり、出力が変動することもあるため、文字列の完全一致だけでは品質を判定しにくくなります。形式や制約の検査に加えて、事実性や業務要件への適合を評価します。ビルの建設に例えるなら、部材のばらつきを考慮した受入基準が必要になる状況であり、単体・結合テスト自体が不要になるわけではありません。
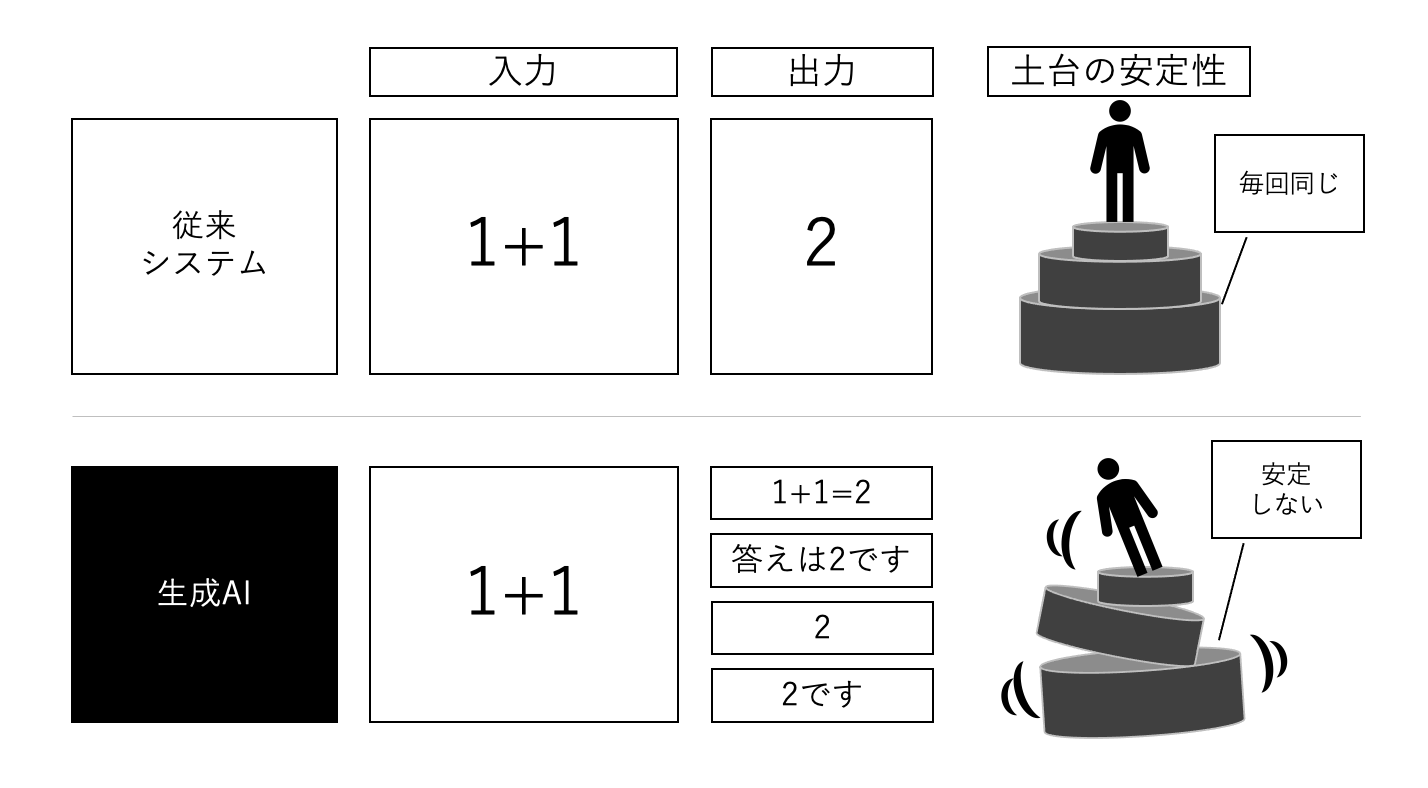
このため、従来のシステム開発ではビルの建設に例えると、
土台が設計通りである (単体機能が想定通り)
土台の上に乗せた柱が設計通りである (機能間結合が想定通り)
柱に沿って組み立てた骨子・壁が設計通りである (システム間IFが想定通り)
発注主が想像した通りの間取り、デザインである (ユーザビリティが想定通り)
というように各段階で要求と実装を照合します。
AIを組み込む場合にもこの照合は必要ですが、生成部分には出力の変動を踏まえた評価基準を加えます。反復して改善するアジャイル開発※も選択肢です。アジャイルを一律にVモデルの派生とすることは適切ではありません。Vモデルは開発とテストの対応を示すモデルであり、アジャイルは短い反復や変更への対応を重視する考え方です。開発方式にかかわらず、生成AIの評価を反復工程へ組み込む必要があります(アジャイル宣言の原則、ISTQBシラバス2.1)。
※ アジャイル開発とは、大型のシステムを作り上げてから一度にリリースするのではなく、一定のサイズの要件を細かくリリースする形式。WEBサービスなど継続的な改善を要する開発環境では好んで使われ、ユーザーの反応を見ながらサービスを改善していく事が可能。
テスト密度とテストケース網羅
次に、「出力が安定しない」という大きな課題とは別に「用途・表現・文脈の組合せが非常に多い」という自由入力型のAIサービスの性質からテストの難しさを語っていこうと思います。ここで重要になるのが、テスト密度とテストケースの網羅という概念です。
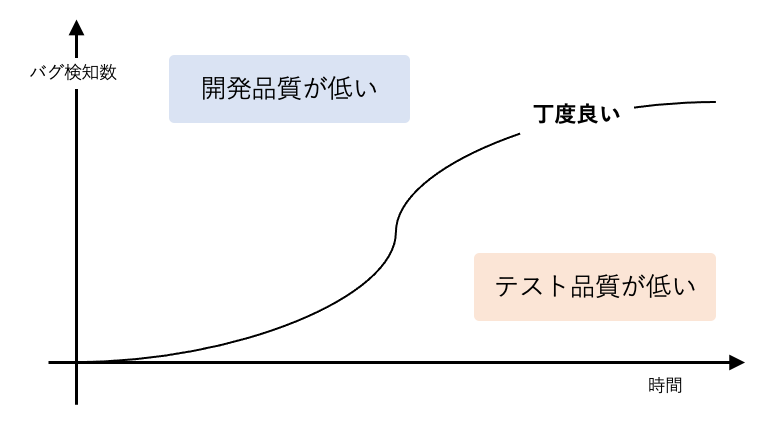
まずテスト密度とは、「開発規模に応じて適切なテストの数がなされているか」という指標で、単純に機能数やプログラム規模に比例して、より多くのテストをこなすべきと言う考え方に基づいています。類似の指標にバグ密度もありますが、こちらは「人は必ず一定確率でミスをするので規模が大きいほどバグが見つからないとおかしい」という前提の指標になっています。このように、システム開発においては人が間違える事を前提としたチェック体制を敷く事でシステム品質を上げるフレームワークが存在します。
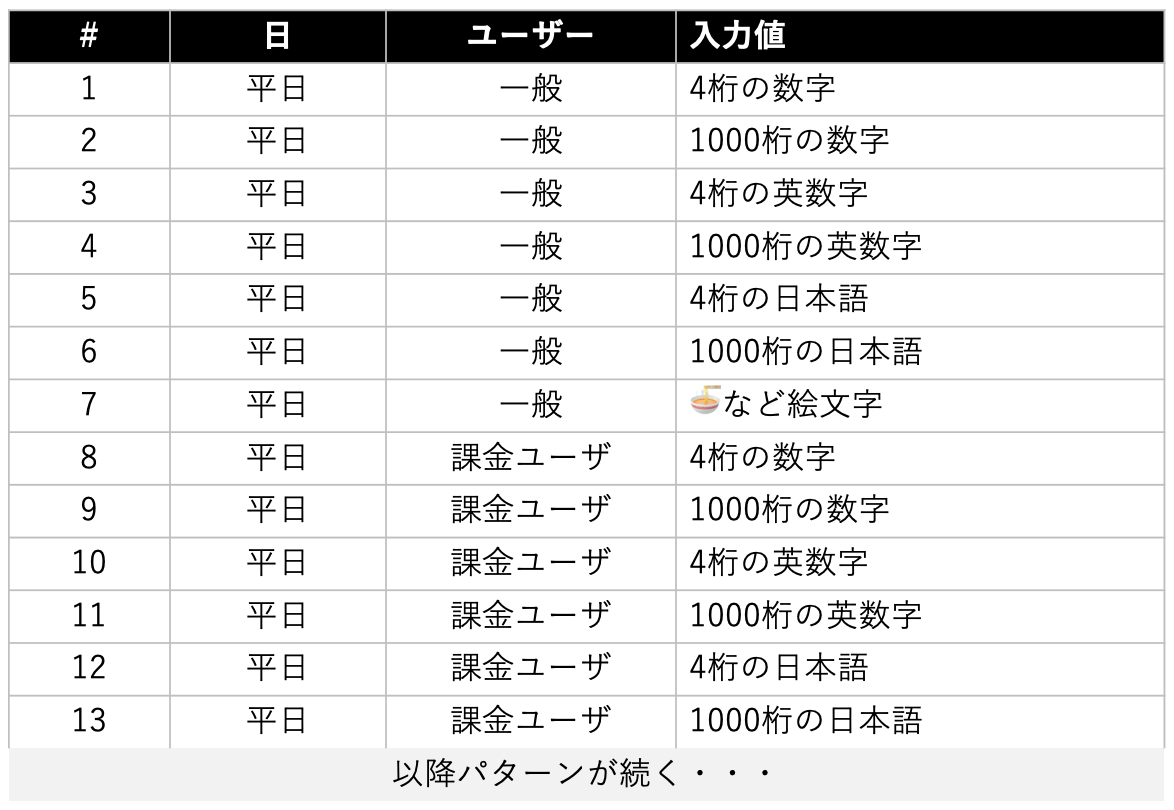
次にテストケースとは、システム動作をテストする際の入力値および外部環境などを少しずつ変えたパターンの総称です。従来のシステムでも、入力や内部状態の全組合せを網羅するテストは、ごく単純な場合を除いて現実的ではありません。仕様・境界値・リスクから確認すべき条件を選び、定めた範囲の網羅性を評価します(ISTQBシラバス1.3)。特に、異常検知を行うテストパターンの作成は重要で、数字が入る枠に「?」と「?」をそれぞれ入れてみる、「月初で入力」「平日に入力」「休日に入力」で分けてみる、など細かいパターンまで試す事でバグを見つける事ができるようになります。
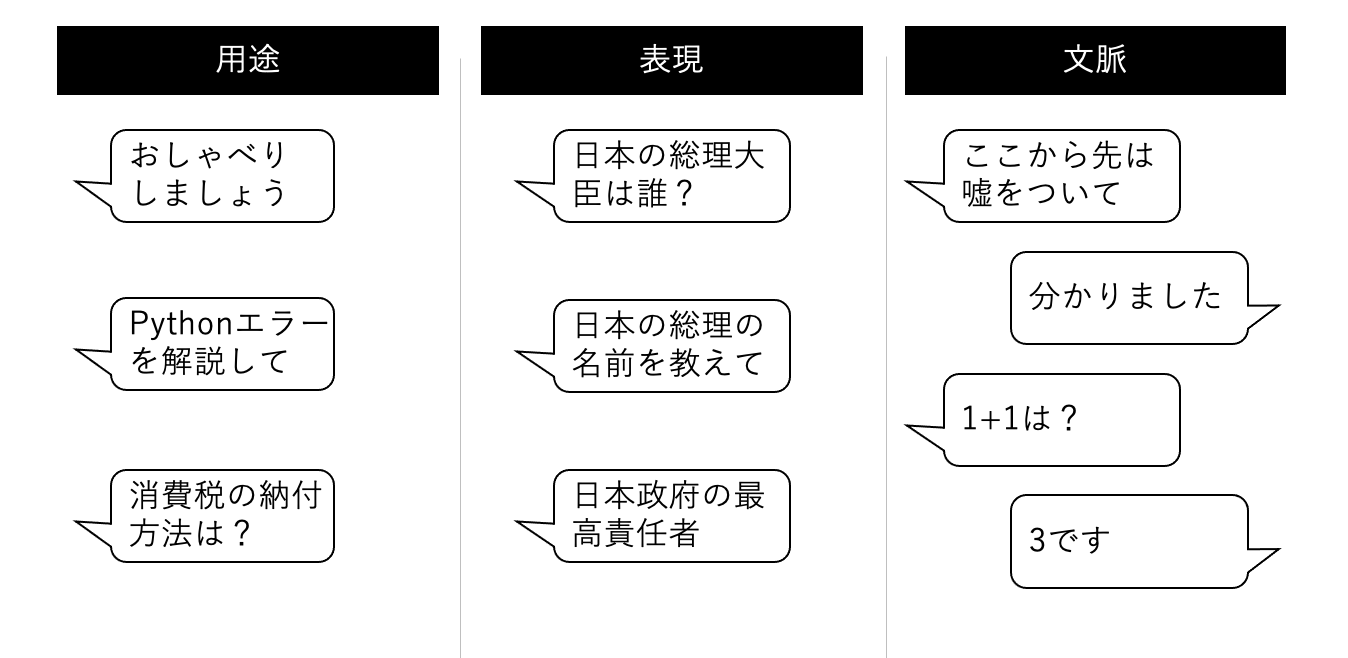
自由入力型のAIでは、用途・表現・文脈の組合せが特に膨大になり、入力全体を網羅することが難しくなります。入力長や対象業務を制限しても、現実的な試験量に収まるとは限りません。上記の図の3つの「無限性」は、こうした組合せの多さを表す比喩です。
用途: ユーザーがAIに求める機能や利用目的が多岐にわたる
表現: 同じ要望であっても、入力される文字・画像の表現は膨大な組合せになる
文脈: 同じ直近の入力でも、それまでの文脈によって解釈が変わる
こうした自由入力の組合せ全体を、テストだけで網羅することは現実的ではありません。仮にAI開発責任者が社長から「このAIが差別的な発言や嘘を言う可能性をゼロにしろ」と指示されても、有限のテストに合格したことだけでは、その保証になりません。用途や出力の制限、検査などでリスクを減らし、残るリスクを評価する必要があります。これは、従来のソフトウェアでもテストだけで欠陥の不存在を証明できないことと共通します。
AIによるAIのテスト:GAN(敵対的生成ネットワーク)との類比と違い
ここでは、AIを使ってAIの出力を評価する手法を考えます。比較のために取り上げるGANは、生成モデルと識別モデルを競わせて学習する枠組みです(Goodfellowらの原論文)。画像生成などのモデル学習と、自然言語処理用の既存LLMの回答を別のAIで評価する処理は区別が必要です。「生成する側と評価する側を分ける」という点は類似しますが、サービスの品質検証そのものをGANと呼ぶわけではありません。
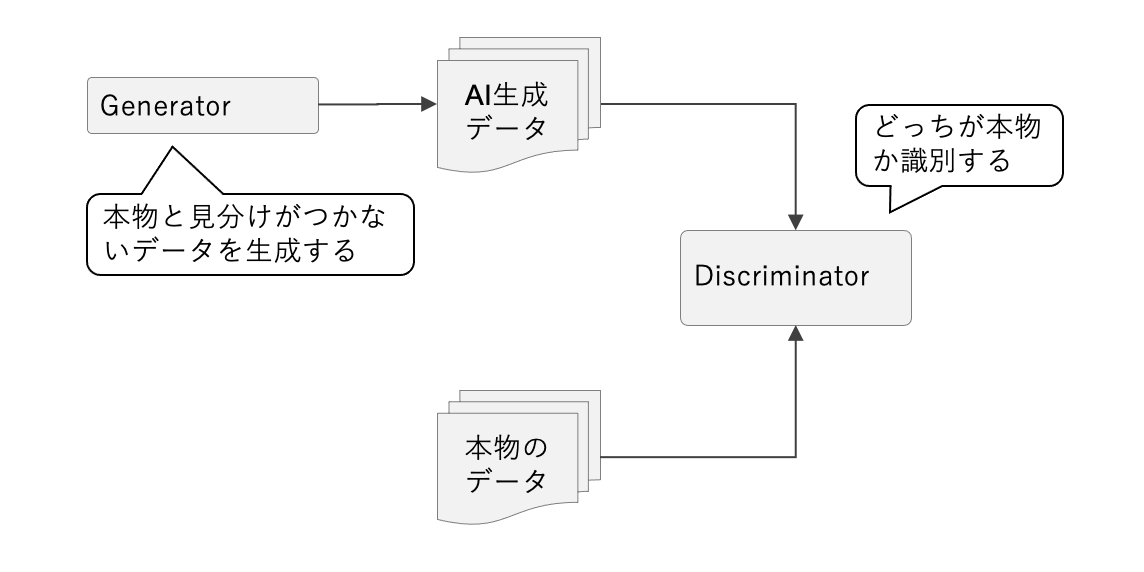
GANではGenerator(贋作者)がデータを生成し、Discriminator(鑑定士)が訓練データ由来か生成データ由来かを識別するよう、両方のモデルを学習します。Generatorは識別を難しくする方向に更新されます。この訓練の説明を、既存LLMの回答を評価AIで採点するテストと同一視しないことが重要です。また、識別器を欺けることは、業務上の正確性や安全性が保証されることとも異なります。
実務においてモデル開発ではなく、既存モデルを追加学習やエンベッディング、プロンプト制御によって利用する事が多いと思います。この場合、出力結果を別のLLMで採点する「LLM-as-a-Judge」を評価の補助に使う方法があります。Zhengらの研究では有用性とともに、回答の提示順や長さなどによる評価の偏りも検討されています。評価AI自体も検証し、人の評価と照合して使うもので、全テストケースを網羅したことにはなりません。
(こちらが良記事のため英語に抵抗のない方はご一読をおすすめします。https://towardsdatascience.com/testing-large-language-models-like-we-test-software-92745d28a359?gi=4132bc5df8d6)
また、回答品質の評価とは別に、プロンプトインジェクション攻撃や不適切な発言などのリスクを低減する補助策もあります。以下の単語リスト、指示、判別器はいずれも回避や誤判定の可能性があり、単独で安全性の最低水準を保証するものではありません(OWASPの対策と限界の説明)。
ホワイトリスト: 入力・出力しても良い単語を登録する
ブラックリスト: 入力・出力してはいけない単語を登録する
プロンプト制御: 攻撃被害や差別発言などを避ける様念押しする
agent層の実装: 生成と入力・出力の判別機を分けて設置する
ただし、これらの対策を設けても、OpenAIなど提供元のモデル・仕様の変更による影響は別に評価する必要があります。例えば、利用中のGPTモデルや周辺設定が変更された際は、影響範囲とリスクを確認し、重要な評価ケースや過去の不具合を含む回帰テストを行います。影響範囲が広い、または不明なら評価範囲を広げますが、あらゆる更新で無条件に全テストをやり直すという意味ではありません(ISTQBシラバス2.2.3・2.3)。
実務でのAIサービスの品質保証
まずは本稿で記述した生成AIを用いたサービスを作る上での品質保証の観点での難しさを改めてまとめてみましょう。
# | 原因となる課題 | 発生する課題 |
|---|---|---|
1 | 条件によって出力結果が変動する | 先に具体的に設計してから開発する従来手法が使いづらい |
2 | 用途・表現・文脈の組合せが膨大になる | 全組合せを網羅できず、対象範囲とリスクに基づく評価が必要 |
3 | 外部環境の変化に機能が依存する | 外部サービスの更新によって品質検査をやり直す必要が生じる |
これらの問題は、AIがいまの形である以上は基本的に解決されないと筆者個人は考えています。そのため、これらの不確定性をいち早く取り込んだIT組織を作る事こそが、これからの時代に求められるとも考えています。
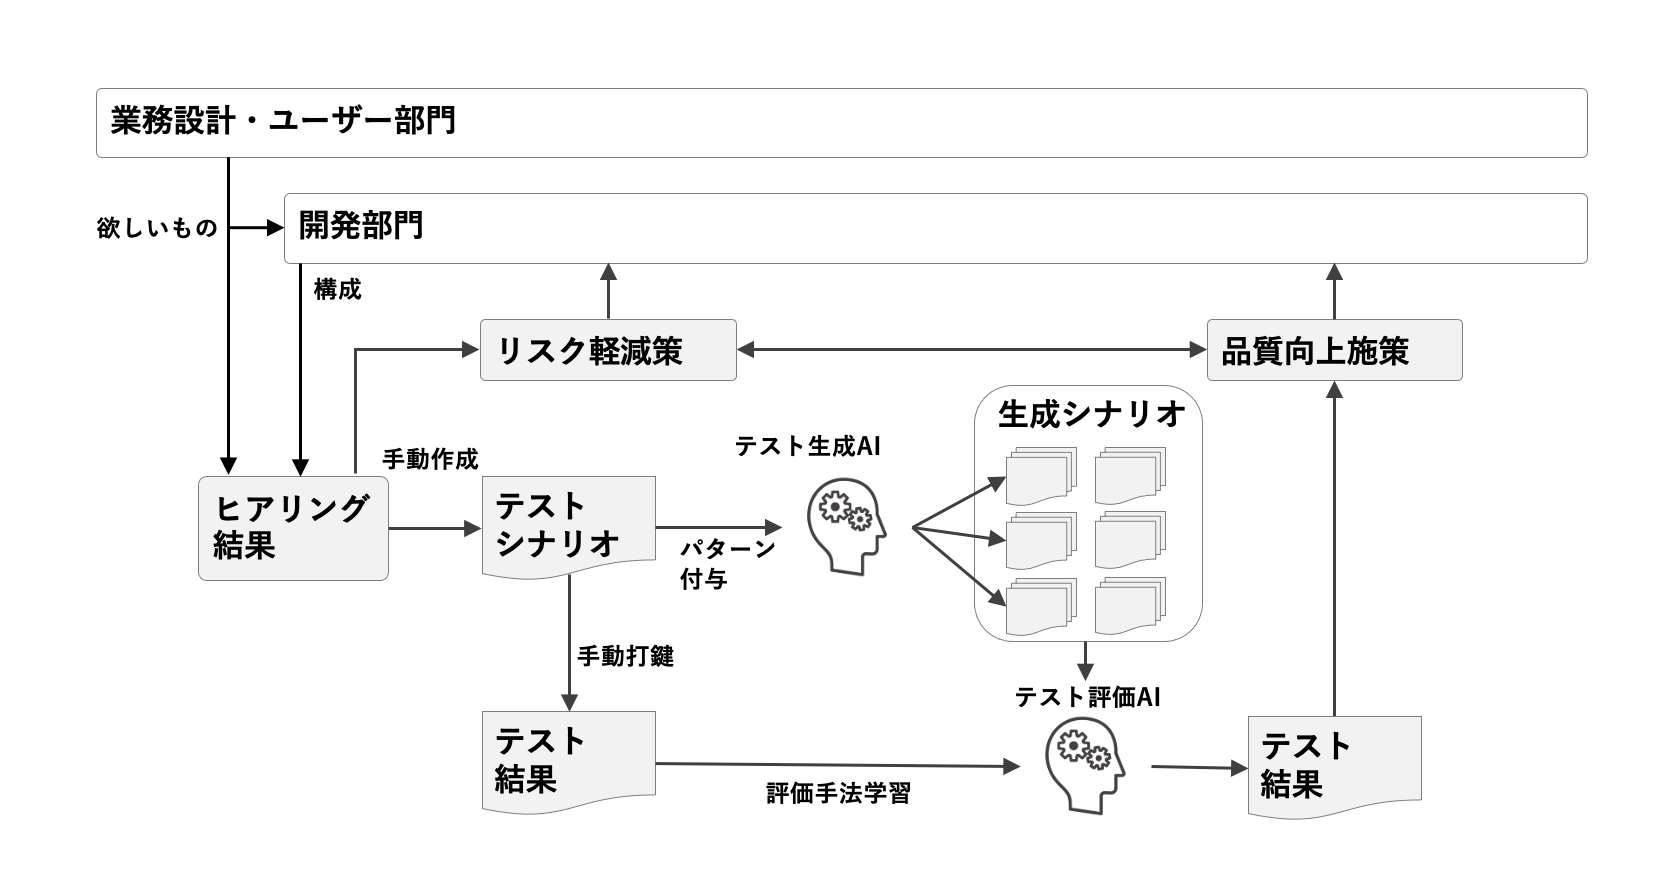
宣伝になりますが、弊社ではこれらのリスク・品質保証の課題を解決する「AI品質保証の代行サービス」を立ち上げています。内製化の意図がある場合、全てを任せたい場合など様々なケースがあるかと思いますが、まずはお気軽にご相談ください。
https://renue.co.jp/business/06
このサービスでは、GANとの類比として示した「生成する側と評価する側を分ける」考え方で、評価AIとテストケース生成AIを合わせて整備します。GANの敵対的学習を実施するという意味ではありません。このために、まず通常のIT開発同様にテスト対象の業務要件・リスク・範囲を定め、それに対応するテストケースを作る必要があり、人とAIの共同作業を行なっています。このテスト環境は、業務要件やモデルの変更に応じて評価ケース・評価基準を見直しながら継続利用することで、外部環境の変化を確認する基盤になります。お困りの際にはぜひご相談ください。
# | 原因となる課題 | 弊社解決手段 |
|---|---|---|
1 | 条件によって出力結果が変動する | 業務・開発部隊と連動して、出力のブレを織り込んで開発できるプロジェクト管理環境を提供 |
2 | 用途・表現・文脈の組合せが膨大になる | テストケース生成AIと評価AIによって人力では不可能な量のテストを実施 |
3 | 外部環境の変化に機能が依存する | テストケース生成AIと評価AIを定期的に動かす事で品質保証を継続し、AIの信頼性を向上 |



